
რა მოხდება, თუ Toyota Corolla-ს მართვას ChatGPT-ს, Claude-ს და Grok-ს მიანდობთ?
თვითმართვადი ავტომობილები უკვე აღარავის უკვირს, არც ხელოვნური ინტელექტისა და ჰუმანოიდი რობოტების ავტოწარმოებაში აქტიურად გამოყენება. თუმცა, ეს ექსპერიმენტი ამ ყველაფრისგან მცირედით განსხვავებულია.
ინჟინერმა ექსპერიმენტისთვის რეალური Toyota Corolla აიღო და მისი მართვა, ხელოვნური ინტელექტის ჩატბოტებს, ChatGPT-ს, Claude-სა და Grok-ს მიანდო. მას სურდა ენახა, რამდენად შეძლებდნენ AI-მოდელები დამოუკიდებლად ნამდვილი ავრომობილის მართვას. რა თქმა უნდა, ექსპერიმენტი უსაფრთხოების წესების დაცვით, ცარიელ ავტოსადგომზე და კონტროლირებად გარემოში ჩატარდა.
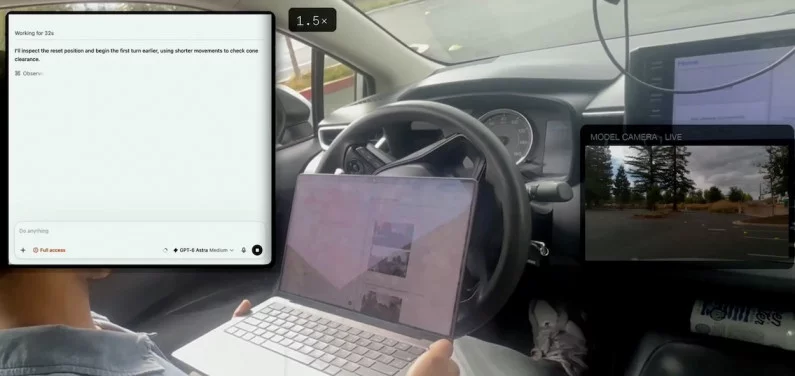
ექსპერიმენტისთვის ინჟინერმა სტანდარტული Toyota Corolla-ს საჭე, აქსელერატორი და მუხრუჭები AI-სისტემებთან დააკავშირა. ავტომობილის კამერები გარემოზე ვიზუალურ ინფორმაციასაც აგროვენდნე, რომელსაც სისტემა AI-მოდელებს ტექსტის სახით აწვდიდა. თავის მხრივ, მოდელები ტექსტური ბრძანებებით განსაზღვრავდნენ საჭის მოხვევის კუთხეს, აქსელერატორზე დაწოლის დონესა და დამუხრუჭების ძალას.
ექსპერიმენტში OpenAI-ის ChatGPT-ის ორი განსხვავებული მოდელი, Anthropic-ის Claude და xAI-ის Grok მონაწილეობდნენ.
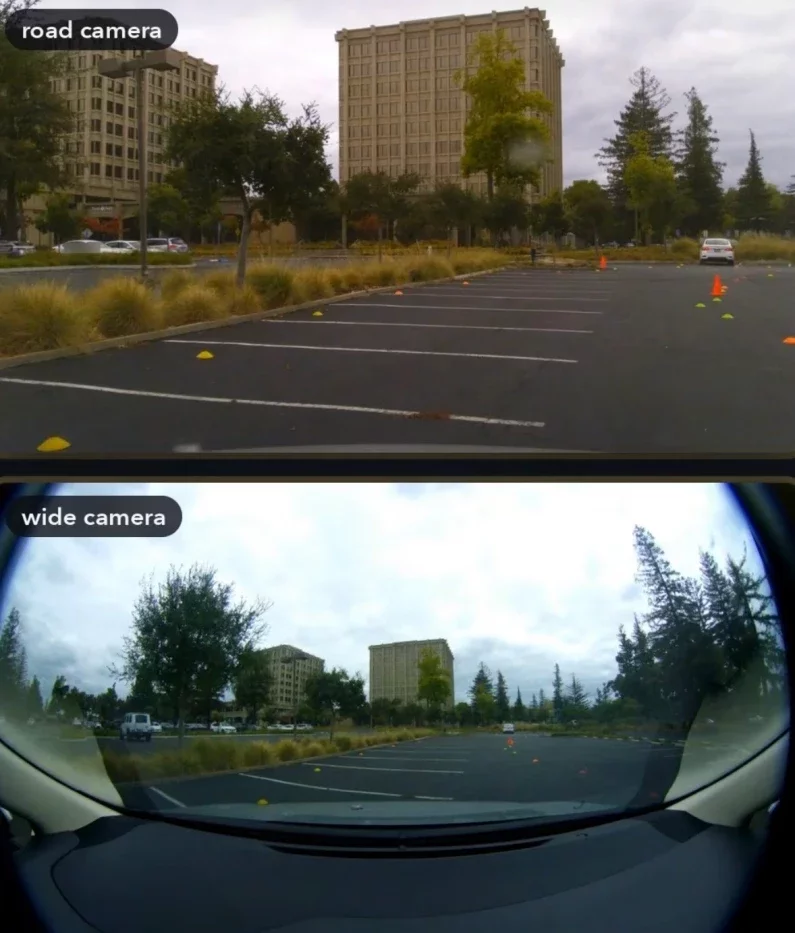
როგორც მოსალოდნელი იყო, ოთხივე მათგანს, ავტომობილის მართვისას, სერიოზული პრობლემები შეექმნა. მთავარი გამოწვევა კი რეაქციის დრო იყო. დიდ ენობრივ მოდელებს ტექსტური ბრძანებების დამუშავებისთვის გარკვეული დრო სჭირდებათ, მაშინ, როდესაც ავტომობილის მართვისას მყისიერი რეაქცია სასიცოცხლოდ მნიშვნელოვანია. გამოვიდა, რომ სანამ AI გადაწყვეტდა, მაგალითად, საჭე რამდენი გრადუსით მოეტრიალებინა, ავტომობილს საკმაოდ დიდი მანძილი უკვე გავლილი ჰქონდა.
ზოგჯერ ისინი ერთმანეთთან შეუსაბამო ბრძანებებსაც გასცემდნენ — მაგალითად, ერთდროულად ავტომობილს 100%-იანი აჩქარებისა და დამუხრუჭების ბრძანებას აწვდიდნენ.
We gave ChatGPT, Claude, and Grok control of a real Toyota Corolla ????, steering/gas/brakes, no human driving (just a foot over the brake).
— DrivingBench (@DrivingBench) September 21, 2026
Only one model was able to complete our entire driving course. Introducing DrivingBench. ????⌛️???? pic.twitter.com/HhukXrByus
საინტერესოა, რომ ოთხივე AI-მოდელი სხვადასხვა პრობლემას ავლენდა. ChatGPT-ს უკეთ გამოსდიოდა გარემოსა და პოტენციური საფრთხეების ამოცნობა, თუმცა ნელი რეაგირება. Grok-ი, პირიქით, უფრო სწრაფად რეაგირებდა, მაგრამ მისი გადაწყვეტილებები ნაკლებად ზუსტი და უსაფრთხო იყო. Claude კი საფრთხეებს კარგად ამჩნევდა, თუმცა ზედმეტად ფრთხილი და ნელი იყო.
ექსპერიმენტის ავტორის შეფასებით, საუკეთესო შედეგი ChatGPT-6 Astra-მ აჩვენა. პირველ ცდაზე მან მარშრუტი ვერ გაიარა, თუმცა მეორე მცდელობისას წინა შეცდომებიდან „ისწავლა“ და ის 5 წუთსა და 22 წამში დაფარა. შედარებისთვის, Claude Fable 5.1-მა ექსპერიმენტისთვის განკუთვნილი მარშრუტის 45% დაფარა, Grok 4.6-მა 11%, ხოლო GPT-5.6 Sol-მა მხოლოდ 6%-ის გავლა შეძლო.


